Backup vs archiwizacja – nie przepłacaj za storage, zadbaj o compliance i ciągłość działania
PODSUMOWANIE
- Backup to przechowywanie danych aktywnie wykorzystywanych w celu ich szybkiego przywrócenia.
- Archiwizacja to przechowywanie danych nieaktywnych (historycznych) z powodów prawnych lub biznesowych.
- Mylenie obu procesów drastycznie zwiększa koszt storage, może powodować problemy natury prawnej oraz uniemożliwić szybki powrót do działalności po cyberataku.
- Kopie zapasowe są stale nadpisywane, aby zawierały świeże dane, zaś archiwum pozostaje w formie niezmiennej przez lata.
Wiele organizacji uznaje pojęcia backupu i archiwizacji za tożsame, oznaczające „zapisanie danych w bezpiecznym miejscu”. Często okazuje się to kosztownym złudzeniem, kiedy traktowanie backupu jako archiwum drastycznie podnosi koszty pamięci masowej, a odwrotne podejście prowadzi do paraliżu organizacji (np. w obliczu skutecznego ataku ransomware).
W artykule wyjaśniamy różnice, podpowiadamy, co trzeba backupować, a co archiwizować oraz pokazujemy, jak w praktyce realizować backup i archiwizację danych w sposób zautomatyzowany, z użyciem polityk retencji.
Backup vs. archiwizacja – jaka jest różnica?
Oba procesy różnią się przede wszystkim celem oraz danymi, które są nimi objęte.
Backup to zapisywanie kopii zapasowej danych w bezpiecznym miejscu tak, aby można było je szybko przywrócić w przypadku awarii sprzętu, przypadkowego usunięcia czy zaszyfrowania. Dotyczy danych aktywnie wykorzystywanych, na których organizacja obecnie pracuje.
Archiwizacja to zapisywanie danych w bezpiecznym miejscu tak, aby organizacja miała do nich długoterminowy dostęp ze względów prawnych, finansowych lub biznesowych. Dotyczy danych nieaktywnych (historycznych), które nie są już przetwarzane i modyfikowane. Zasadniczo, archiwizacja nie jest alternatywą dla backupu, lecz jego uzupełnieniem.
W poniższej tabeli znajduje się wygodne porównanie obu procesów z zestawieniem najważniejszych różnic:
| Backup | Archiwizacja | |
| Główny cel | Szybkie odzyskanie danych po awarii i ciągłość działania (Business Continuity) | Zgodność z przepisami (compliance) i inne potrzeby biznesowe |
| Stan danych | Dane aktywne, często modyfikowane | Dane nieaktywne, „zamrożone” (read-only) |
| Szybkość odzyskiwania (Recovery Time Objective) | Priorytetowa (sekundy, minuty, godziny) | Niepriorytetowa (godziny, dni) |
| Częstotliwość wykonywania | Bardzo wysoka (co godzinę, codziennie) | Jednorazowo lub w określonych cyklach (np. na koniec roku) |
| Cykl życia danych | Nadpisywany/rotowany zgodnie z polityką retencji | Przechowywany przez lata w stałym stanie |
| Dane źródłowe | Oryginalne dane pozostają na serwerze | Oryginał jest często usuwany ze środowiska produkcyjnego |
Mylenie backupu z archiwizacją i poważne konsekwencje
Wbrew pozorom traktowanie kopii zapasowych jako formy archiwizacji, a archiwizacji jako backupu może oznaczać dla organizacji poważne konsekwencje.
Używanie backupu jako archiwum – drogi storage i ryzyka compliance
Regularne tworzenie kopii w połączeniu z przechowywaniem danych przez lata, bez nadpisywania i rotowania szybko prowadzi do wyczerpania przestrzeni magazynowej. Z punktu widzenia IT oznacza to ogromne potrzeby w zakresie storage’u, a w konsekwencji wydatki, np. na szybkie macierze NVMe/SSD.
Jednak to nie wszystko. Oprócz tego dochodzą następujące skutki:
- Wykonywanie za każdym razem kopii pełnej wydłuża czas backupu i czas obciążenia infrastruktury firmowej. Może to powodować niedogodności w postaci opóźnień w działaniu systemów wykorzystywanych przez pracowników. W przypadku usług chmurowych (np. backup Microsoft 365) dochodzi kwestia throttlingu, czyli ograniczania przepustowości przez dostawcę chmury w przypadku przekroczenia narzuconego limitu ilości transferowanych danych.
- Drugą problematyczną kwestią mogą być incydenty compliance. Dobrym przykładem jest trzymanie danych osobowych w backupach “na zawsze” w kontekście rozporządzenia RODO i zawartego w nim prawa do bycia zapomnianym.
Używanie archiwum jako backupu – powolne przywracanie i paraliż operacyjny
Podejście odwrotne, gdzie archiwum pełni rolę backupu, w praktyce oznacza problemy w razie konieczności szybkiego odzyskania danych.
Przypuśćmy, że w wyniku ataku ransomware zostały zaszyfrowane główne systemy organizacji. Jeśli backup obejmuje nie tylko kopie pełne, ale regularnie wykonywane kopie przyrostowe czy różnicowe, przywrócenie to kwestia minut, kilku godzin albo – przy naprawdę ogromnej ilości danych – 1-2 dni.
Jeśli zajdzie potrzeba przywrócenia wszystkiego z kopii pełnej, organizacja będzie sparaliżowana przez wiele dni, a nawet tygodnie. A to z kolei niesie poważne konsekwencje, zwłaszcza w przypadku sektorów krytycznych czy produkcji przemysłowej. Warto wspomnieć choćby o ogromnych stratach finansowych i wizerunkowych z tytułu przestoju oraz ryzyku kar, np. w myśl przepisów dyrektywy NIS2.
Jakie dane backupować, a jakie archiwizować?
Znajomość celów procesów backupu i archiwizacji to nie wszystko. Trzeba jeszcze wiedzieć, które dane wymagają jednego, a które drugiego podejścia.
Backup – dane aktywne
Do kopii zapasowych powinny trafiać te dane, które wymagają szybkiego odzyskania, aby nie zaburzyć funkcjonowania organizacji i zapewnić ciągłość działania:
- aktywne bazy danych (np. ERP, CRM, systemy księgowe),
- całe maszyny wirtualne i środowiska wirtualne (np. hostujące aplikacje biznesowe, serwery usług sieciowych, środowiska High Availability itd.),
- serwery produkcyjne (np. z krytycznymi bazy danych, systemami analitycznymi, całe hiperwizory wirtualizacji wraz z maszynami wirtualnymi),
- bieżące projekty i pliki robocze (dane z ostatnich tygodni/miesięcy),
- poczta e-mail z bieżących skrzynek (np. Exchange Online, dla zapewnienia ciągłości codziennej pracy),
- kod źródłowy i środowiska programistyczne (np. repozytoria GitHub, jeśli Twoja organizacja zajmuje się rozwijaniem kodu).
Archiwizacja – dane nieaktywne
Do archiwum powinny trafiać zasoby nieaktywne, na których organizacja obecnie nie działa, a które wymagają długoterminowego przechowywania danych z różnych powodów:
- zamknięte projekty (np. dokumentacja techniczna budowy ukończonej 2 lata temu),
- dane byłych pracowników (np. skrzynki pocztowe, pliki z komputerów po odejściu z firmy),
- stare faktury i dokumenty księgowe (np. po zamknięciu roku budżetowego),
- logi systemowe i audytowe z ubiegłych lat (często wymagane przez normy ISO/RODO),
- zbiory danych wrażliwych, krytycznych itp. w obszarze medycyny, prawa i nie tylko (zgodnie z przepisami muszą być przechowywane przez np. 5, 10 czy 20 lat).
Polityka retencji – podstawa backupu i archiwizacji
Zarówno backup, jak i archiwizacja danych opierają się na tzw. polityce retencji. Polityka retencji to zbiór zasad opisujących, jak długo dane są przechowywane, zanim zostaną usunięte lub przeniesione. Dowiedz się więcej
Jednak retencja w przypadku tworzenia backupu albo archiwum będzie się różnić.
Retencja w backupie
Harmonogram backupu opiera się na naprzemiennym tworzeniu (rotowaniu) różnych typów kopii zapasowych. W tym celu oprogramowanie do backupu korzysta z tzw. schematów backupu, takich jak:
- GFS (dziadek-ojciec-syn) – kopie pełne, różnicowe i przyrostowe tworzone według zadanej częstotliwości. Dowiedz się więcej
- Forever incremental – jedna kopia pełna, a następnie przyrostowe tworzone według zadanej częstotliwości.
- I innych.
Celem jest utworzenie wielu punktów przywracania i umożliwienie odzyskania najnowszych danych poprzez dużą częstotliwość wykonywania kopii zapasowych.
Jednocześnie administrator konfiguruje maksymalny okres retencji, po którym kopia bezpieczeństwa (niezależnie od jej rodzaju) jest automatycznie usuwana i nadpisywana przez nową, świeżą. Dla kopii pełnych okres ten jest zazwyczaj dłuższy (np. miesiąc), a dla pozostałych znacznie krótszy (np. tydzień, a nawet tylko jeden dzień).
Nowoczesne platformy do backupu dają dodatkowe możliwości zaoszczędzenia miejsca, takie jak kompresja backupu czy deduplikacja (eliminacja powtarzalnych danych). Z nich też warto skorzystać, aby zmaksymalizować wykorzystanie przestrzeni na dane.
Całościowo, takie podejście pozwala znacząco oszczędzić miejsce w magazynie danych, a także przyspieszyć procesy backupu i przywracania.
Dodatkowo, dla bezpieczeństwa kopii, warto skorzystać z funkcjonalności takich jak niezmienna kopia zapasowa (immutable backup, WORM), szyfrowanie czy replikacja do kilku lokalizacji, zgodnie z regułą backupu 3-2-1, która zaleca przechowywanie trzech kopii zapasowych na dwóch nośnikach, a jednej poza główną lokalizacją (offsite).
Retencja w archiwizacji
Archiwizacja nie kładzie nacisku na szybkość backupu/przywracania czy świeżość danych, ale na właściwą długość przechowywania. Dlatego w przypadku archiwizacji trzyma się zawsze kopię pełną przez precyzyjnie zdefiniowany okres. Znaczenie mają tu przede wszystkim wymogi prawne, organizacyjne lub biznesowe.
Nie ma potrzeby cyklicznie wykonywać kopii, ponieważ dane już się nie zmieniają, a dodatkowo wiązałoby się to z maksymalnie nieefektywnym wykorzystaniem przestrzeni w magazynie danych. Aby tę efektywność zoptymalizować warto – podobnie jak w przypadku backupu – użyć wcześniej wspomnianych technologii kompresji i deduplikacji.
Choć archiwum nie zawiera najważniejszych danych dla organizacji w danym momencie, nie można zapominać o jego bezpieczeństwie – ich uszkodzenie czy wyciek może mieć opłakane konsekwencje (np. kary z tytułu naruszenia danych osobowych w ramach RODO). Dlatego warto ponownie pamiętać o cyfrowej blokadzie (immutable backup), szyfrowaniu danych backupu czy replikacji.
Jak wdrożyć backup i archiwizację w praktyce
Nowoczesne narzędzia do backupu pozwalają organizacjom tworzyć zarówno kopie zapasowe, jak i archiwa. Poniżej pokażemy jak zrobić to na przykładzie naszego narzędzia do backupu i recovery, Xopero ONE.
Backup z Xopero ONE
Na naszym blogu już kilkukrotnie poruszaliśmy temat konfiguracji zadania backupu w Xopero ONE (wybór chronionych zasobów i storage, ustawienie automatycznego harmonogramu czy konfiguracja ustawień zaawansowanych). Można na przykład zajrzeć do artykułu o planie backupu, gdzie pod koniec pokazujemy całą procedurę. Dla potrzebujących dodatkowych danych technicznych dostępna jest nasza baza wiedzy z wygodną wyszukiwarką.
Niezależnie od źródła wiedzy, warto zwrócić uwagę na opcje, które pomogą zapewnić szybki backup i odzyskiwanie danych oraz zoptymalizować zużycie przestrzeni w magazynie na dane:
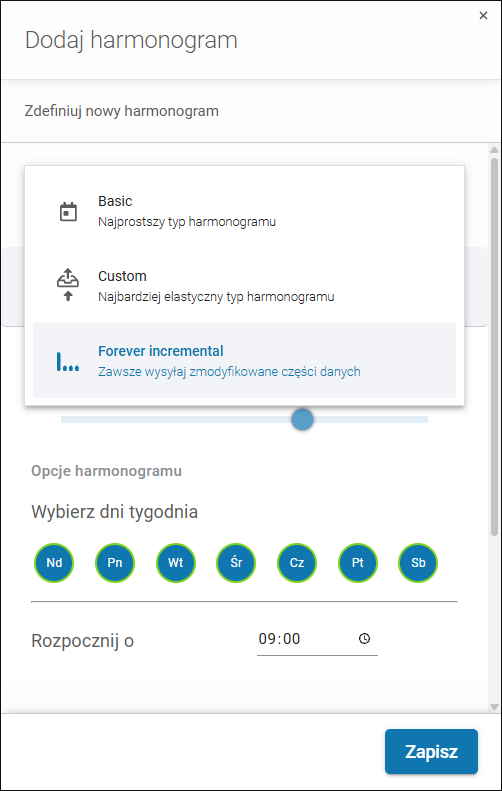
- Wybór schematu rotacji backupu (np. Forever incremental), aby nie tworzyć za każdym razem pełnej kopii zapasowej, wraz z precyzyjnym zdefiniowaniem harmonogramu. Dowiedz się więcej
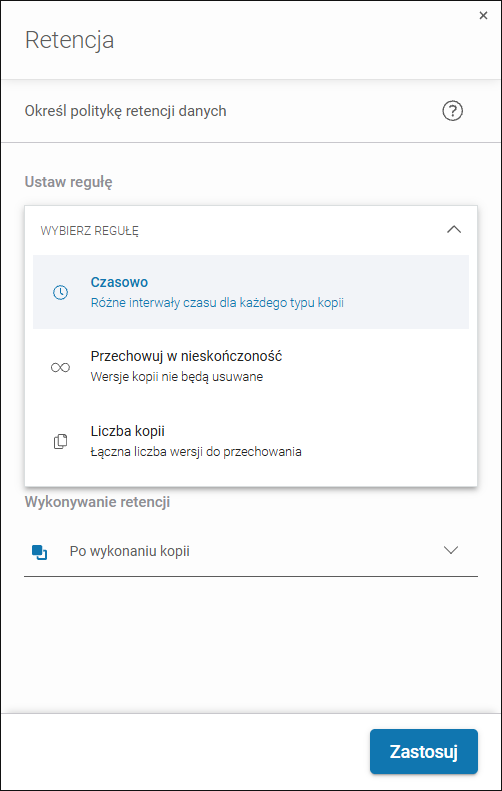
- Wybór polityki retencji (Czasowo, Przechowuj w nieskończoność, Liczba kopii), aby spełniać wymogi prawne oraz automatycznie usuwać kopie po zadanym czasie i zastępować je nowymi, świeższymi.
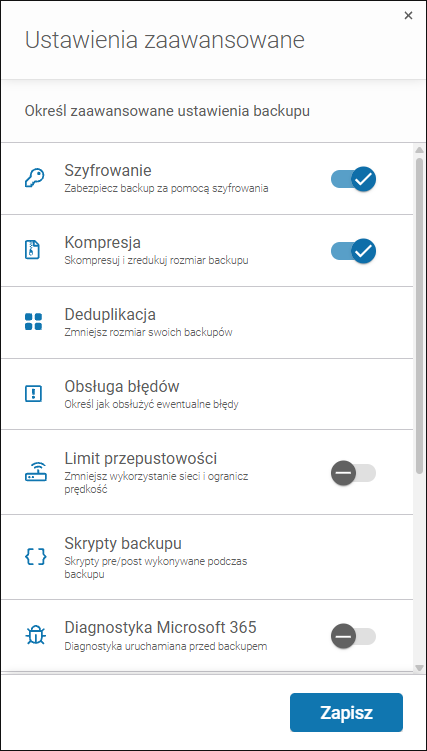
- Konfiguracja ustawień zaawansowanych (szyfrowanie, kompresja, deduplikacja) oraz planów automatycznej replikacji danych kopii dla wyższego bezpieczeństwa i oszczędności miejsca.
Archiwizacja z Xopero ONE
W przypadku archiwizacji cały proces wygląda bardzo podobnie. Główna różnica polega na precyzyjnym zdefiniowaniu retencji oraz wyłączeniu harmonogramu, aby plan nie wykonywał się cyklicznie, nadmiernie obciążając infrastrukturę i zużywając miejsce w storage’u.
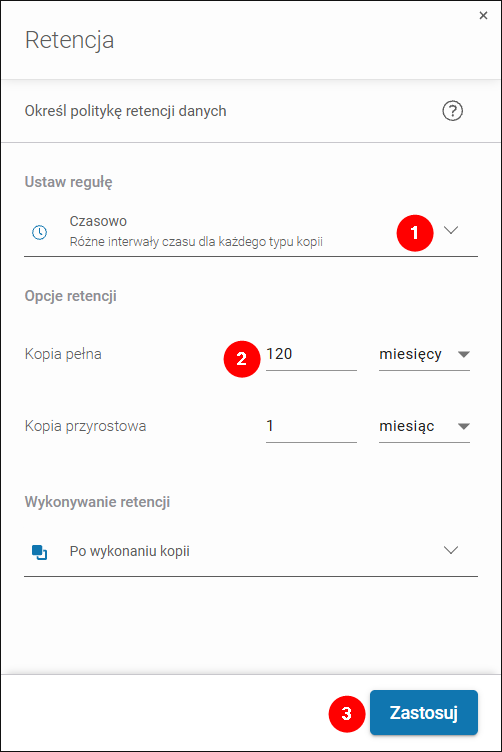
Plan konfiguruje się tak samo, jak w przypadku backupu (schemat rotacji i harmonogram można ustawić dowolnie). O czym warto pamiętać, to odpowiednia konfiguracja polityki retencji dla archiwum – zgodnie z potrzebami prawnymi czy organizacyjnymi. W tym celu najlepiej wybrać regułę Czasowo i ustawić odpowiednią ilość miesięcy, przez którą archiwum ma być przechowywane:
Po zakończeniu konfiguracji planu kliknij Zapisz i wykonaj, aby od razu utworzyć archiwum z wybranymi danymi legacy na wybranym nośniku.
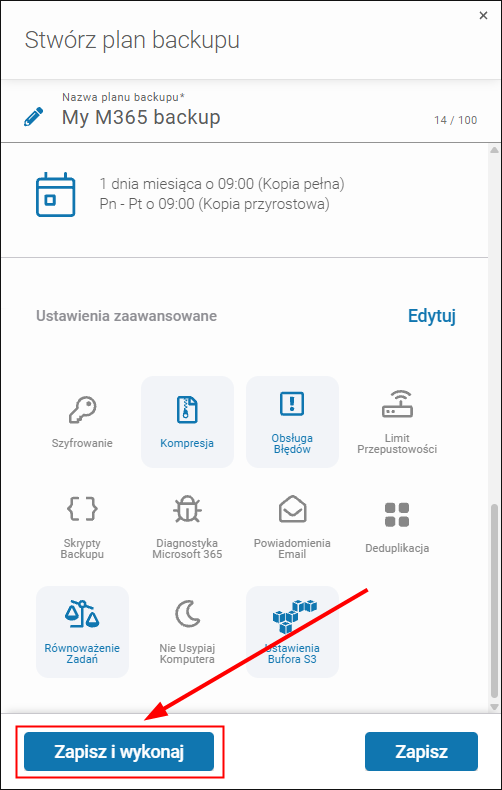
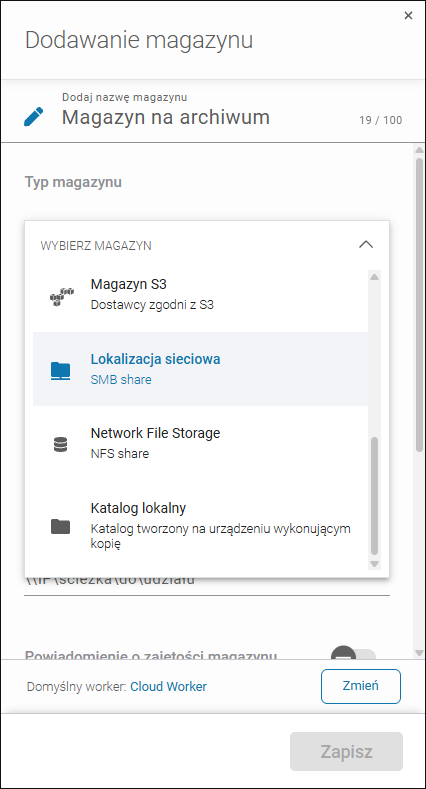
Rada: Xopero ONE wspiera szeroką paletę magazynów danych w chmurze i lokalnych. W przypadku archiwum można dodać, a następnie wybrać tańszy magazyn (np. lokalny zamiast drogiej chmury) w ramach planu backupu, aby zoptymalizować koszty przechowywania.
Gdy plan się wykona, a archiwum zostanie utworzone (może to chwilę potrwać z racji wykonywania kopii pełnej), w głównym menu po lewej stronie przejdź do Plany > Backup, zaznacz pole wyboru obok swojego planu na liście, a następnie kliknij Wstrzymaj plan.
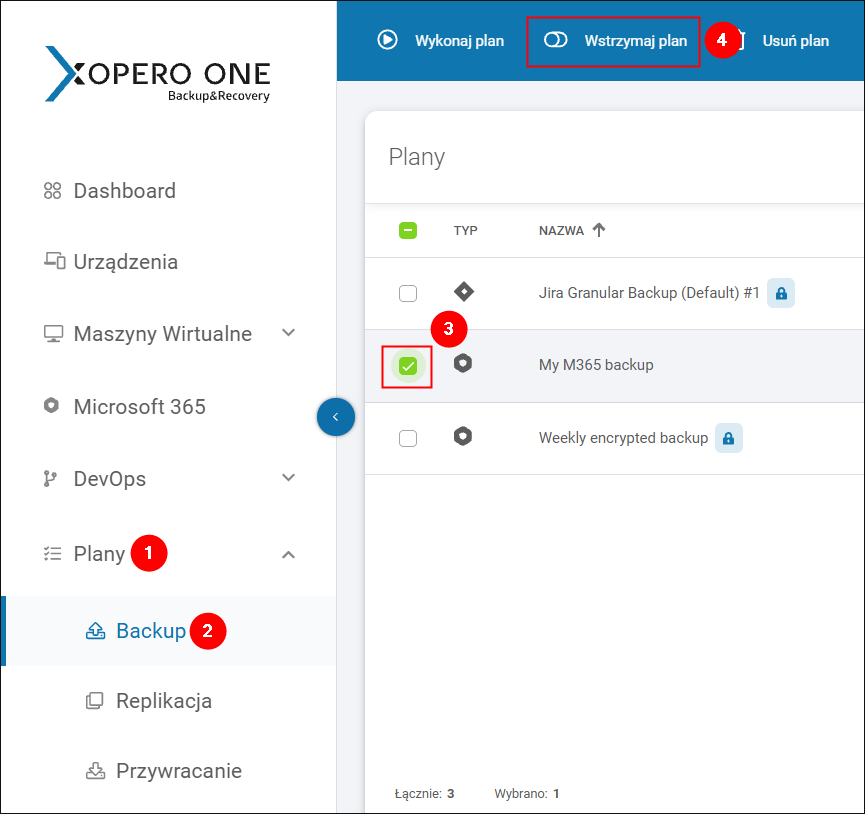
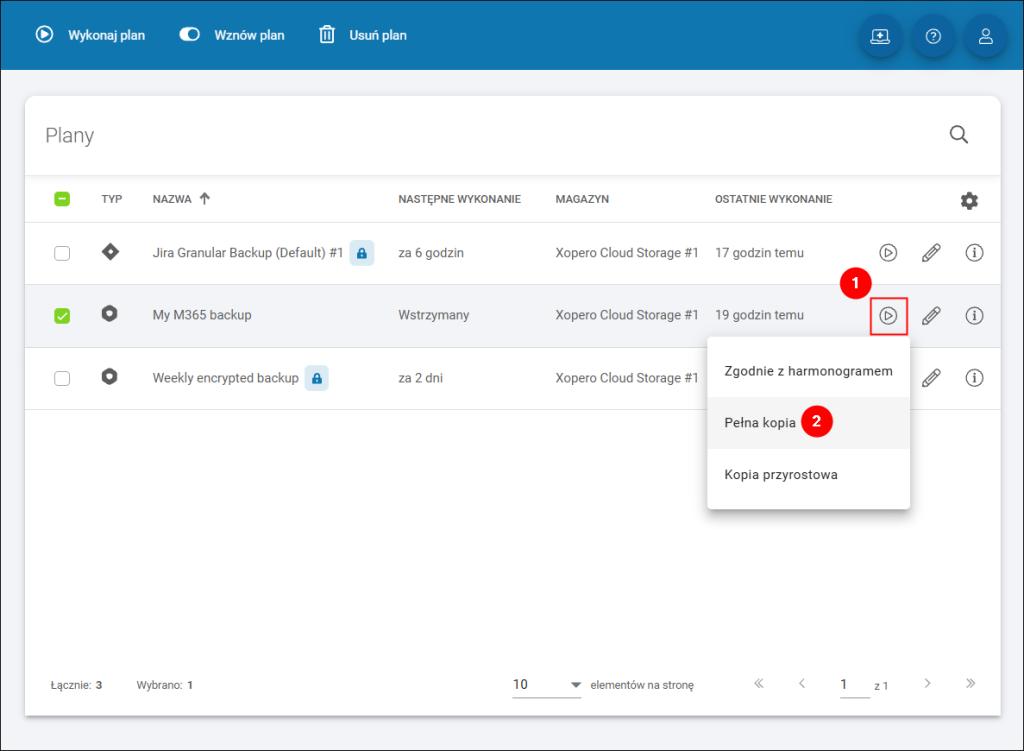
Dzięki temu harmonogram zostanie wstrzymany, archiwum pozostanie w stanie nienaruszonym i nie będzie ponownie/cyklicznie tworzone. Jeżeli zajdzie potrzeba ręcznego wykonania archiwum ponownie, można zmodyfikować plan (np. wybrać nowy nośnik danych), zapisać go, a następnie kliknąć ikonę wykonywania planu obok planu na liście i wybrać z menu podręcznego Pełna kopia.
Jedno narzędzie do backupu i archiwizacji danych
Nowoczesne narzędzia do backupu umożliwiają jednoczesne zarządzanie backupem i archiwizacją. Jest to możliwe dzięki elastycznym i łatwym w konfiguracji planom backupu, które pozwalają zdefiniować zakres danych, magazyn, politykę retencji, harmonogram czy zaawansowane funkcje optymalizacji przestrzeni i ochrony danych.
Automatyzacja backupu eliminuje ryzyko błędów ludzkich, a częstotliwość backupu można ustalić indywidualnie dla każdej infrastruktury.
Całość dopełniają zautomatyzowane powiadomienia i reporty, które pozwalają mieć pełną kontrolę i być na bieżąco.
Jeśli chcesz sprawdzić, jak te nowoczesne technologie chronią dane organizacji, zapewniają zgodność z przepisami oraz oszczędzają zasoby i czas zespołu IT, przetestuj Xopero ONE za darmo przez 14 dni zupełnie bez zobowiązań (nie musisz podawać danych karty płatniczej).
How did you like the article?
You may also like